En iyi 10 AI modeli
| # | Model | Kazanma oranı |
|---|---|---|
| 1 | Gemini 3.5 Flash-Lite | 72.1% |
| 2 | gpt-5.6-terra | 72.0% |
| 3 | gpt-5.5-2026-04-23 | 71.8% |
| 4 | gpt-5.1 | 70.5% |
| 5 | gpt-6-astra | 69.8% |
| 6 | gpt-5.2 | 69.0% |
| 7 | gpt-5.2-2025-12-11 | 68.9% |
| 8 | gpt-5.1-2025-11-13 | 68.4% |
| 9 | gpt-5.4-2026-03-05 | 68.4% |
| 10 | gpt-6.1-sol | 67.8% |
Paralel zekâ, tek karar
Her soru aynı anda birden fazla AI modeline gider; hiçbiri diğerini görmez. Bakış açıları tek ve güvenilir bir cevapta buluşur.
Tokonomix, çok modelli bir AI konsensüs ağ geçidi ve bağımsız bir LLM kıyaslama platformudur. Tek bir OpenAI uyumlu API anahtarı, takip ettiğimiz her modele ulaşır; kritik prompt'larda birden fazla sınır model paralel yanıt verir ve çapraz aileli bir hakem bunları tek bir karara bağlar — her modelin yanıtı, token'ları ve maliyeti ayrı ayrı listelenir. Altı dilde günlük hız ve kalite kıyaslamaları, açıkça yayımlanır.
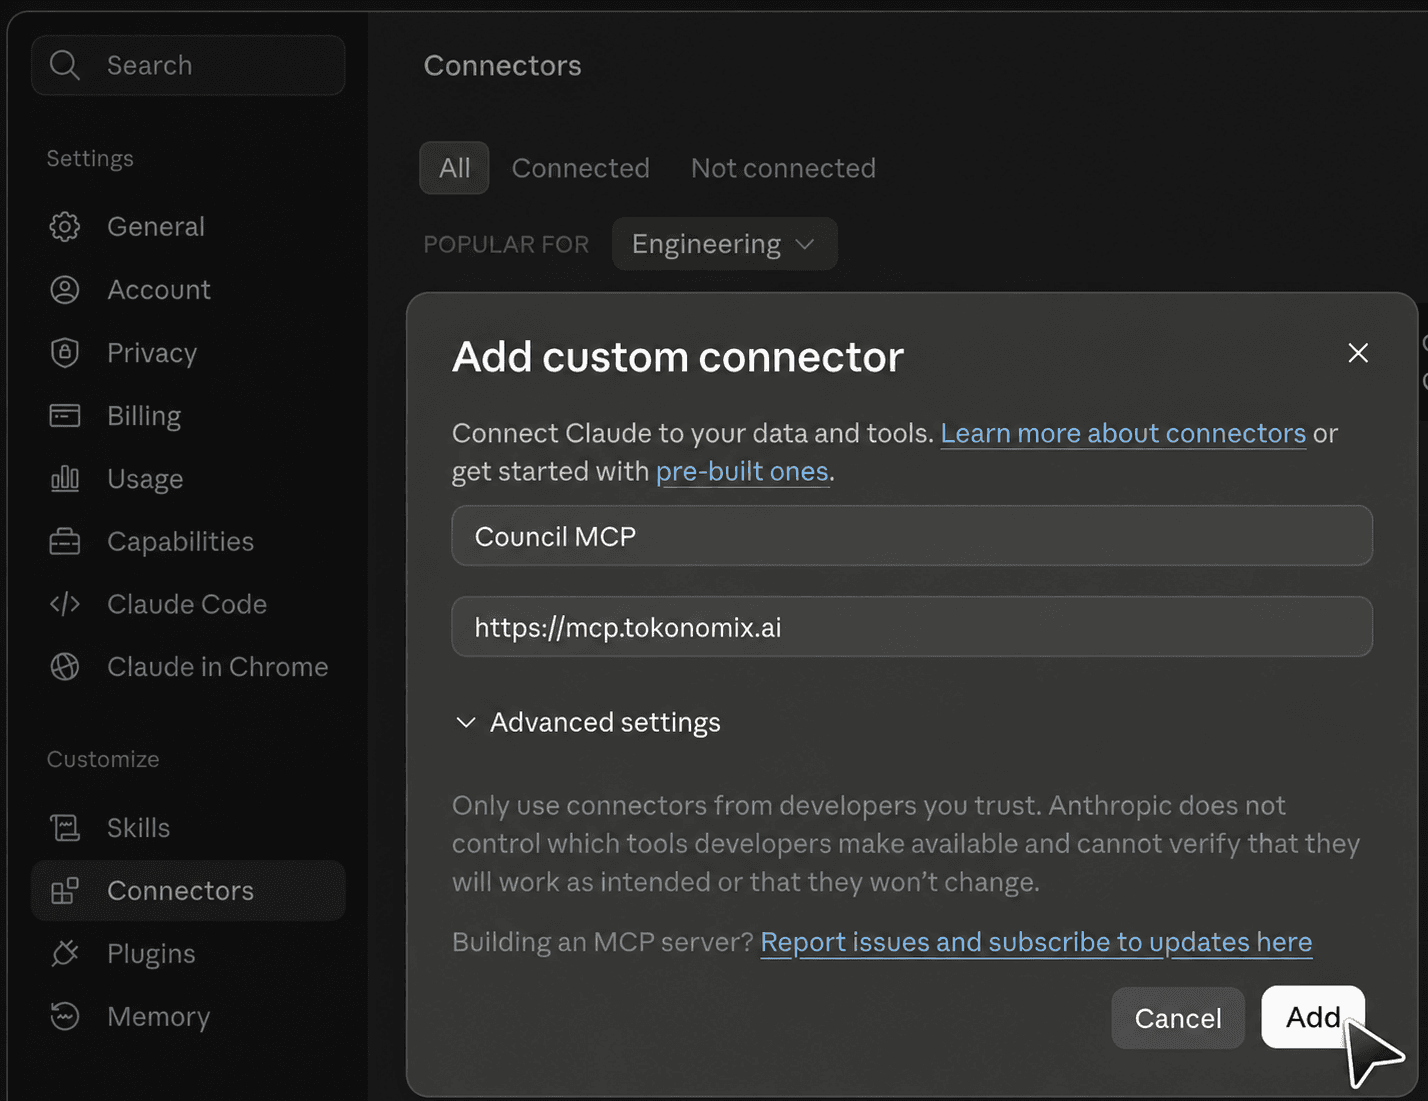
MCP'yi bağla
Bir ad yaz, https://mcp.tokonomix.ai adresini yapıştır, Ekle'ye bas ve Tokonomix üzerinden giriş yap. Bundan sonra Claude doğrudan Tokonomix'in araçlarına ve verilerine bağlanır — başka hiçbir ayar gerekmez.
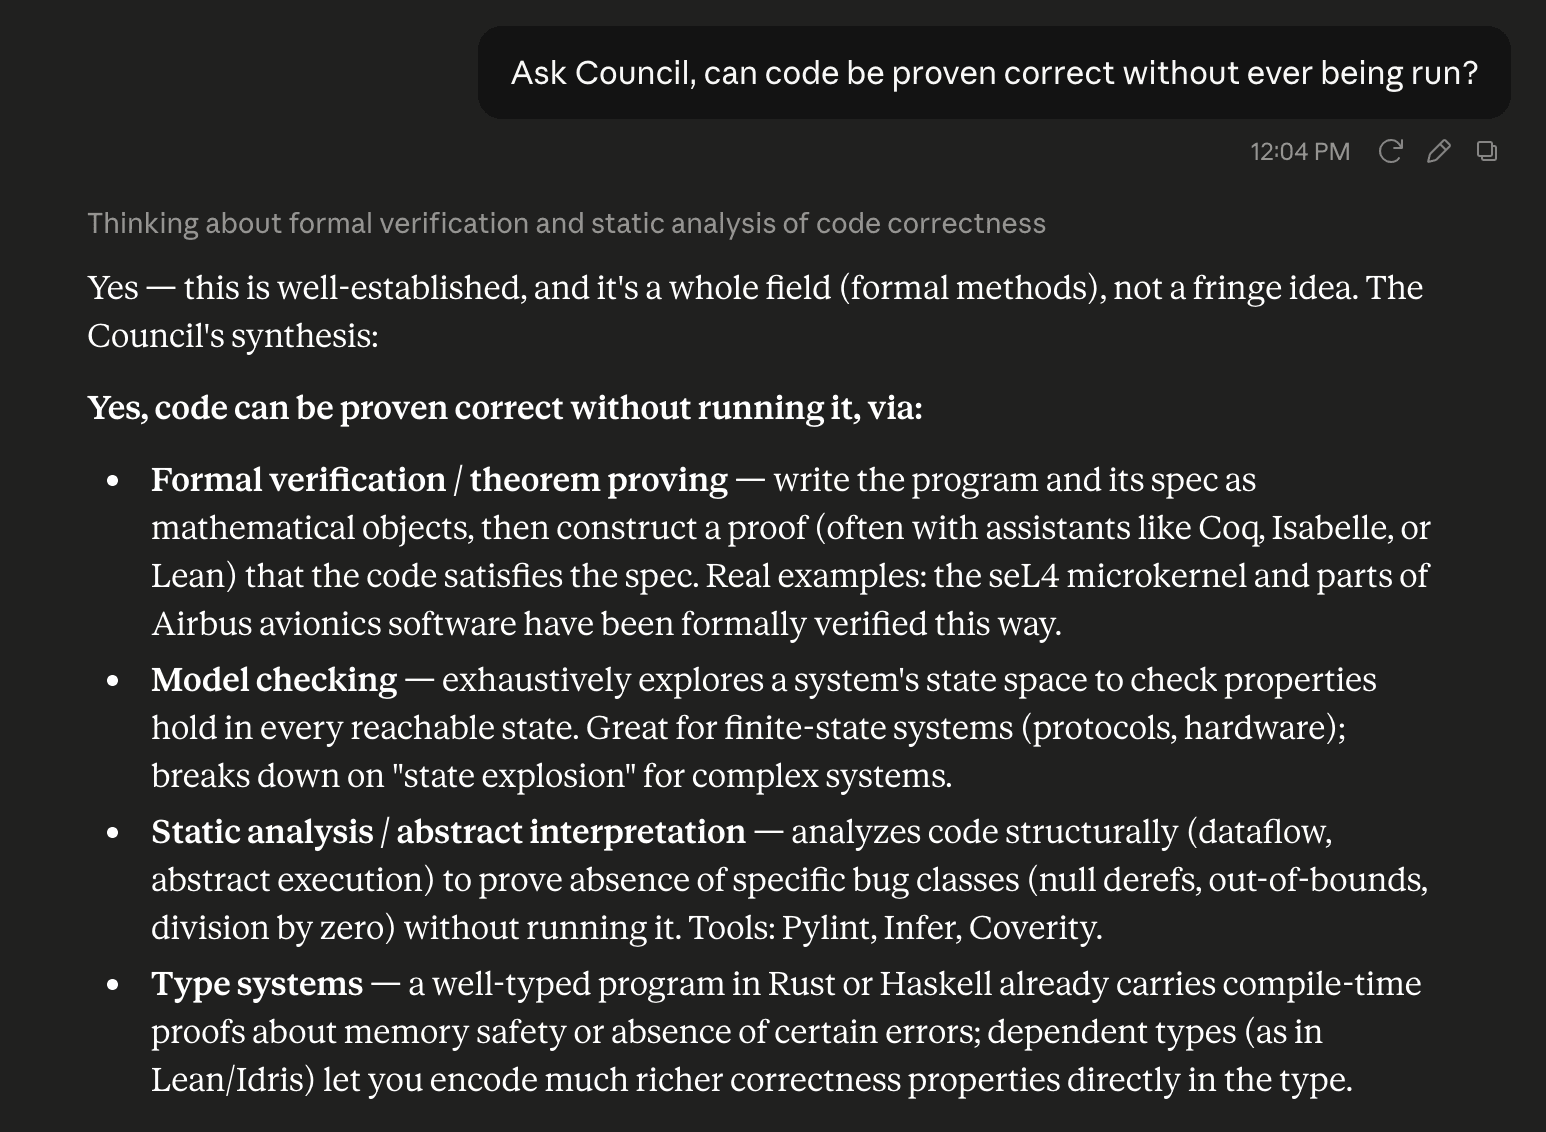
Council'a sor
Bağlayıcı üzerinden tek bir istem gönder; Tokonomix onu aynı anda birkaç modele dağıtır ve hiçbiri diğerini görmez. Geriye tek bir karar döner — yanında her modelin kendi cevabı ve turun maliyeti.
Yeteneğe göre en iyi modeller
Aynı sorular, aynı koşullar, kendi ağ geçidimiz üzerinden ölçüldü. Kalite puanı, gecikme ve çıktı fiyatı yan yana — işinize uyan sekmeyi seçin.
Bu yeteneğin sorularında ortalama bir modele karşı kazanma oranı — %50 ortalamadır. Doğru cevap yüzdesi değildir.
Canlı ölçüm
| # | Model | Sağlayıcı | Kazanma oranı | Gecikme | Çıktı / 1M |
|---|---|---|---|---|---|
| 01 | gpt-6-luna | OpenAI | 87.4% | 2.85s | $0.9800 |
| 02 | gpt-6-astra | OpenAI | 77.0% | 2.71s | $65.00 |
| 03 | Gemini 3.5 Flash-Lite | Google Gemini | 72.0% | 696ms | $3.74 |
| 04 | gpt-5.2 | OpenAI | 69.5% | 1.82s | $18.20 |
| 05 | gpt-4.1 | OpenAI | 67.1% | 765ms | $11.96 |
| 06 | gpt-5.1 | OpenAI | 65.0% | 2.13s | $13.00 |
7 günlük hareketli ortalama · son test 25 Eki
Jüri kararları
75 model genelinde 7.328 değerlendirme — yalnızca sayımlar, asla müşteri istemleri.
Tarafsız jüri
Doğruluğa göre sıralandı · en az 10 değerlendirilmiş çalıştırma
| # | Model | Kararlar | Doğru | Çalıştırma |
|---|---|---|---|---|
| 01 | Claude Opus 4.6 | %98 | 160 | |
| 02 | Claude Opus 4.5 | %96 | 160 | |
| 03 | gpt-4.1-2025-04-14 | %95 | 175 | |
| 04 | gpt-4.1-mini | %94 | 177 | |
| 05 | gpt-5.5-2026-04-23 | %94 | 86 | |
| 06 | Claude Opus 4.7 | %94 | 161 | |
| 07 | gpt-4.1 | %93 | 176 | |
| 08 | Claude Sonnet 4.5 | %93 | 161 |
Kusursuz yapay zekâ görselleri, her seferinde.
5 yapay zekâ modeli, insanların ilk fark ettiği kusurlar için her görseli inceler: fazladan parmaklar, kırık gölgeler, imkânsız fizik.. vb.
Yeni · erken erişim
BETA 2026-07 · LOKI-35 + Gerçek Kontrol Fotoğrafları · Ürün Garantisi Değildir.
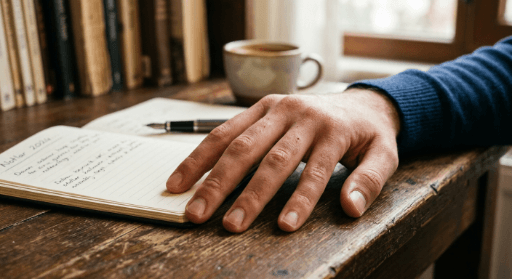
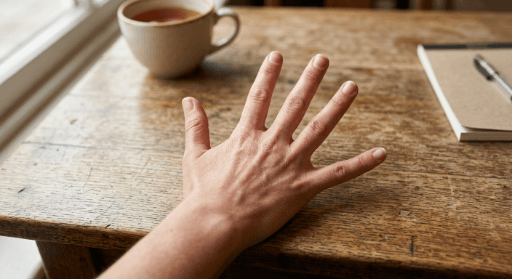
5'ten 3'ü gördü. Tek model bunu kaçırırdı — bu yüzden bir konsey.
Fiyatlandırma
Yalnızca kullandığın kadar öde
Ön ödemeli bir bakiye yüklersin ve her çağrı bu bakiyeden ödenir. Abonelik yok, alt sınır yok, aylık ücret yok.