Top 10 KI-Modelle
| # | Modell | Gewinnrate |
|---|---|---|
| 1 | Gemini 3.5 Flash-Lite | 72.1% |
| 2 | gpt-5.6-terra | 72.0% |
| 3 | gpt-5.5-2026-04-23 | 71.8% |
| 4 | gpt-5.1 | 70.5% |
| 5 | gpt-6-astra | 69.8% |
| 6 | gpt-5.2 | 69.0% |
| 7 | gpt-5.2-2025-12-11 | 68.9% |
| 8 | gpt-5.1-2025-11-13 | 68.4% |
| 9 | gpt-5.4-2026-03-05 | 68.4% |
| 10 | gpt-6.1-sol | 67.8% |
Parallele Intelligenz, eine Entscheidung
Jede Frage geht gleichzeitig an mehrere KI-Modelle, blind füreinander. Ihre Perspektiven laufen zu einer verlässlichen Antwort zusammen.
Tokonomix ist ein Multi-Modell-KI-Konsens-Gateway und unabhängiger LLM-Benchmark. Ein OpenAI-kompatibler API-Key erreicht jedes Modell, das wir verfolgen; bei kritischen Prompts antworten mehrere Frontier-Modelle parallel, und ein familienübergreifender Judge führt sie zu einem Urteil zusammen — mit Antwort, Tokens und Kosten je Modell einzeln aufgeschlüsselt. Tägliche Geschwindigkeits- und Qualitätsbenchmarks in sechs Sprachen, offen veröffentlicht.
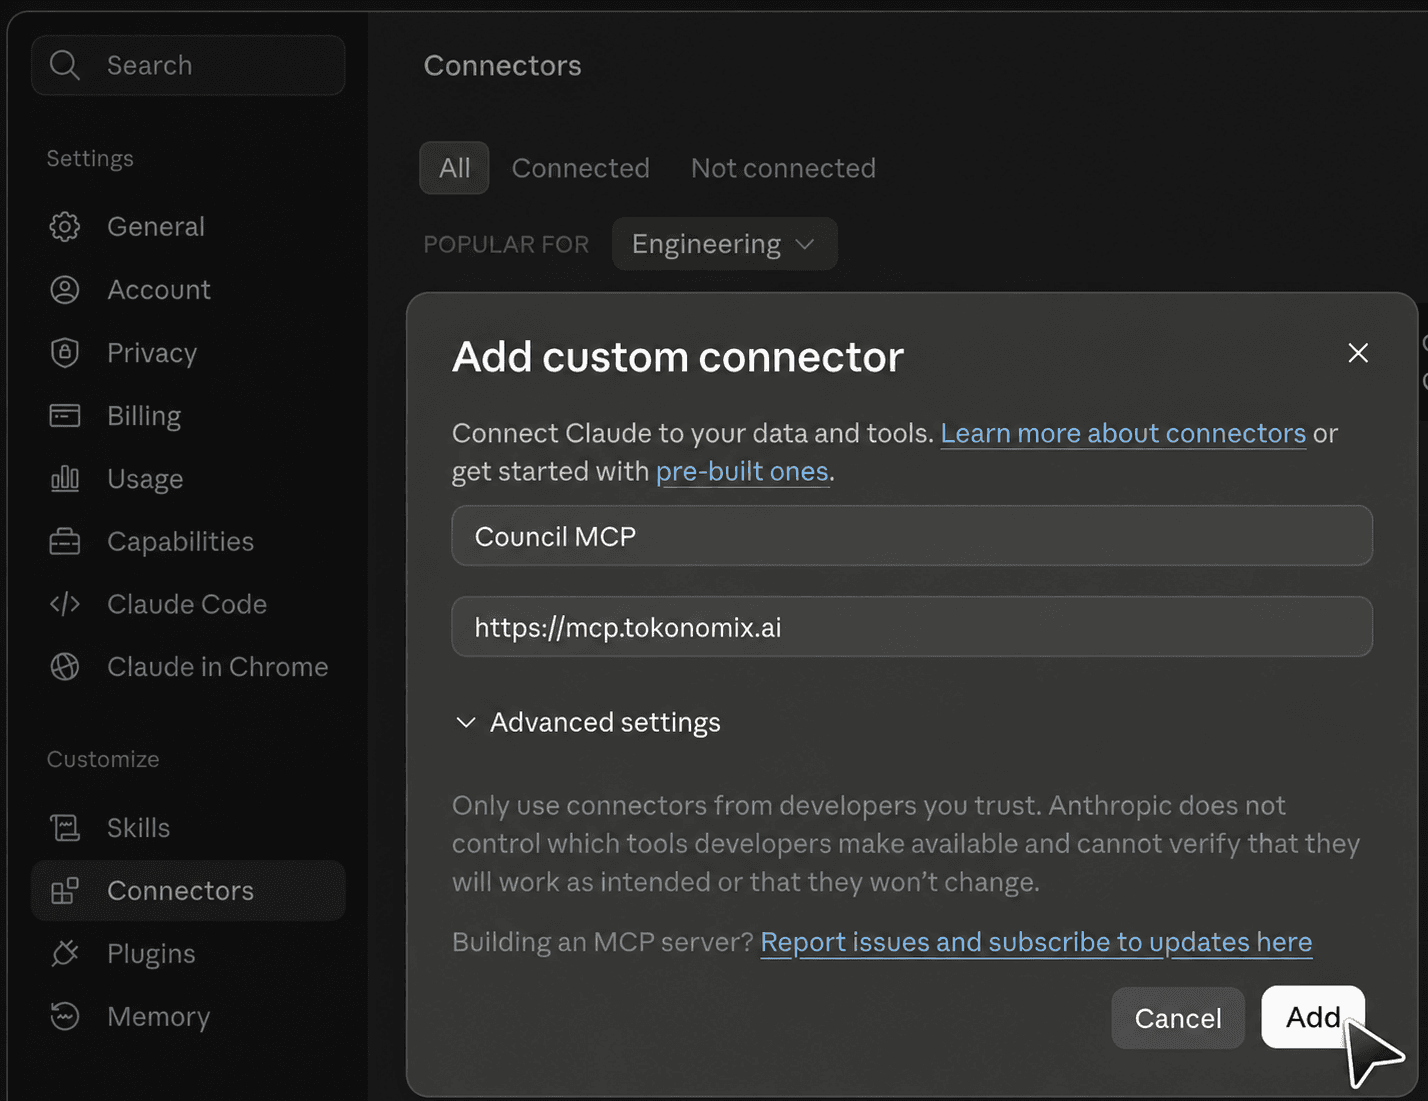
MCP verbinden
Namen eintragen, https://mcp.tokonomix.ai einfügen, auf Hinzufügen klicken und über Tokonomix anmelden. Ab dann greift Claude direkt auf die Tools und Daten von Tokonomix zu — mehr ist nicht einzurichten.
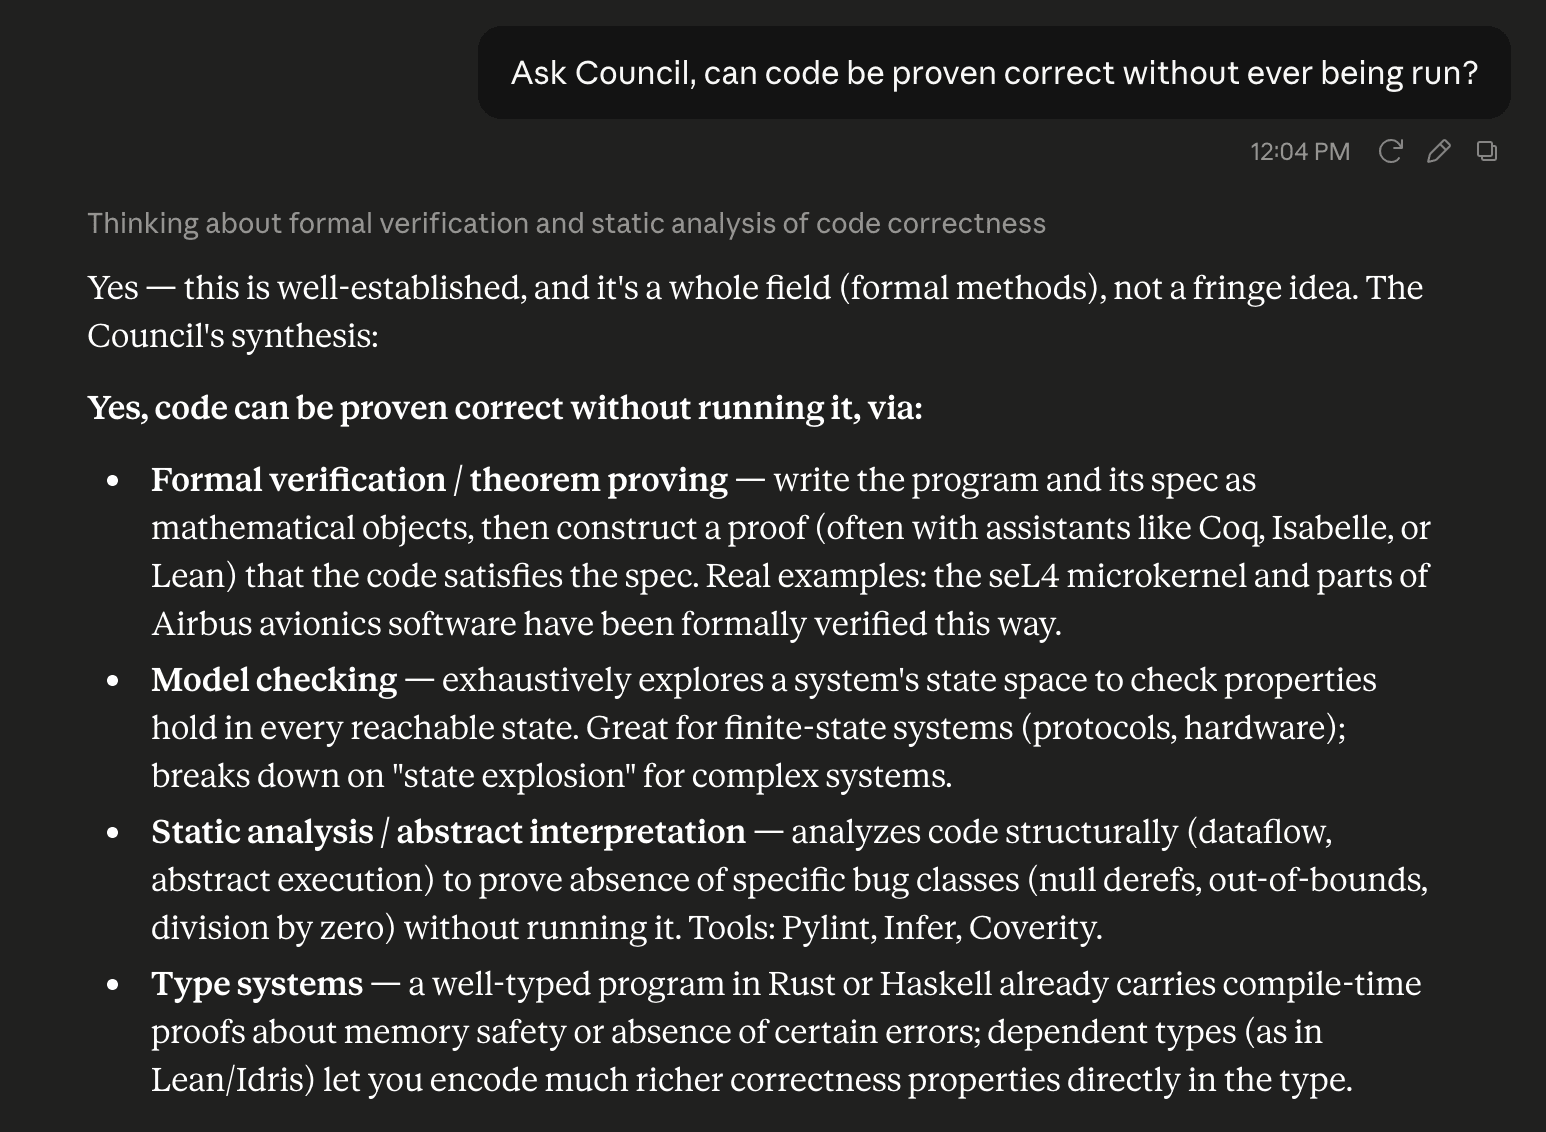
Frag das Council
Schick einen Prompt durch den Connector, und Tokonomix legt ihn mehreren Modellen gleichzeitig vor — blind füreinander. Zurück kommt ein Urteil, dazu die Antwort jedes einzelnen Modells und die Kosten der Runde.
Topmodelle, nach Fähigkeit
Dieselben Prompts, dieselben Bedingungen, über unser eigenes Gateway gemessen. Qualitätsscore, Latenz und Ausgabepreis nebeneinander — wählen Sie den Tab, der zu Ihrer Aufgabe passt.
Gewinnrate gegen ein durchschnittliches Modell bei den Prompts dieser Fähigkeit — 50% ist der Durchschnitt. Kein Prozentsatz richtiger Antworten.
Live Bench
| # | Modell | Anbieter | Gewinnrate | Latenz | Ausgabe / 1M |
|---|---|---|---|---|---|
| 01 | gpt-6-luna | OpenAI | 87.4% | 2.85s | $0.9800 |
| 02 | gpt-6-astra | OpenAI | 77.0% | 2.71s | $65.00 |
| 03 | Gemini 3.5 Flash-Lite | Google Gemini | 72.0% | 696ms | $3.74 |
| 04 | gpt-5.2 | OpenAI | 69.5% | 1.82s | $18.20 |
| 05 | gpt-4.1 | OpenAI | 67.1% | 765ms | $11.96 |
| 06 | gpt-5.1 | OpenAI | 65.0% | 2.13s | $13.00 |
7-Tage-Durchschnitt · letzter Test 25. Okt.
Urteile der Jury
7.328 Bewertungen über 75 Modelle — nur Zählwerte, niemals Kunden-Prompts.
Neutrale Jury
Sortiert nach Korrektheit · mindestens 10 bewertete Läufe
| # | Modell | Urteile | Korrekt | Läufe |
|---|---|---|---|---|
| 01 | Claude Opus 4.6 | 98 % | 160 | |
| 02 | Claude Opus 4.5 | 96 % | 160 | |
| 03 | gpt-4.1-2025-04-14 | 95 % | 175 | |
| 04 | gpt-4.1-mini | 94 % | 177 | |
| 05 | gpt-5.5-2026-04-23 | 94 % | 86 | |
| 06 | Claude Opus 4.7 | 94 % | 161 | |
| 07 | gpt-4.1 | 93 % | 176 | |
| 08 | Claude Sonnet 4.5 | 93 % | 161 |
Liefern Sie makellose KI-Bilder, jedes Mal.
5 KI-Modelle prüfen jedes Bild auf die Fehler, die Menschen zuerst bemerken: zusätzliche Finger, gebrochene Schatten, unmögliche Physik.. usw.
Neu · Early Access
BETA 2026-07 · LOKI-35 + Echte Kontrollfotos · Keine Produktgarantie.
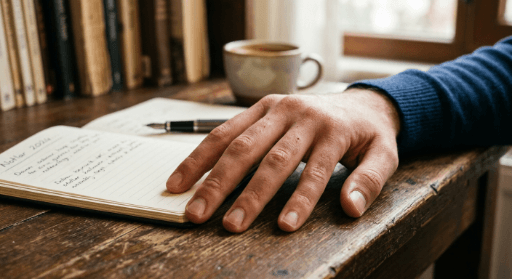
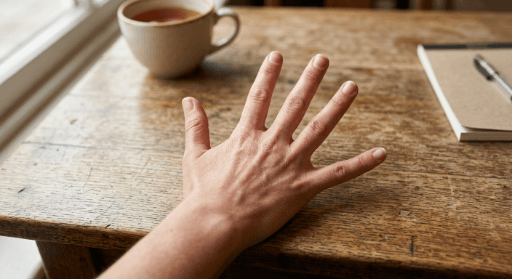
3 von 5 haben es gesehen. Ein Modell allein hätte es übersehen — darum ein Rat.
Preise
Zahle nur, was du nutzt
Du lädst ein Guthaben auf, und jeder Aufruf wird daraus bezahlt. Kein Abo, kein Mindestbetrag, keine Monatsgebühr.