Top 10 des modèles d'IA
| # | Modèle | Taux de victoire |
|---|---|---|
| 1 | Gemini 3.5 Flash-Lite | 72.1% |
| 2 | gpt-5.6-terra | 72.0% |
| 3 | gpt-5.5-2026-04-23 | 71.8% |
| 4 | gpt-5.1 | 70.5% |
| 5 | gpt-6-astra | 69.8% |
| 6 | gpt-5.2 | 69.0% |
| 7 | gpt-5.2-2025-12-11 | 68.9% |
| 8 | gpt-5.1-2025-11-13 | 68.4% |
| 9 | gpt-5.4-2026-03-05 | 68.4% |
| 10 | gpt-6.1-sol | 67.8% |
Intelligence parallèle, décision unique
Chaque question part vers plusieurs modèles d'IA à la fois, aveugles les uns aux autres. Leurs perspectives convergent vers une seule réponse fiable.
Tokonomix est une passerelle de consensus IA multi-modèles et un benchmark LLM indépendant. Une seule clé API compatible OpenAI donne accès à tous les modèles que nous suivons ; pour les prompts à fort enjeu, plusieurs modèles frontier répondent en parallèle et un juge inter-famille les réconcilie en un seul verdict — avec la réponse, les tokens et le coût détaillés pour chaque modèle. Benchmarks quotidiens de vitesse et de qualité en six langues, publiés ouvertement.
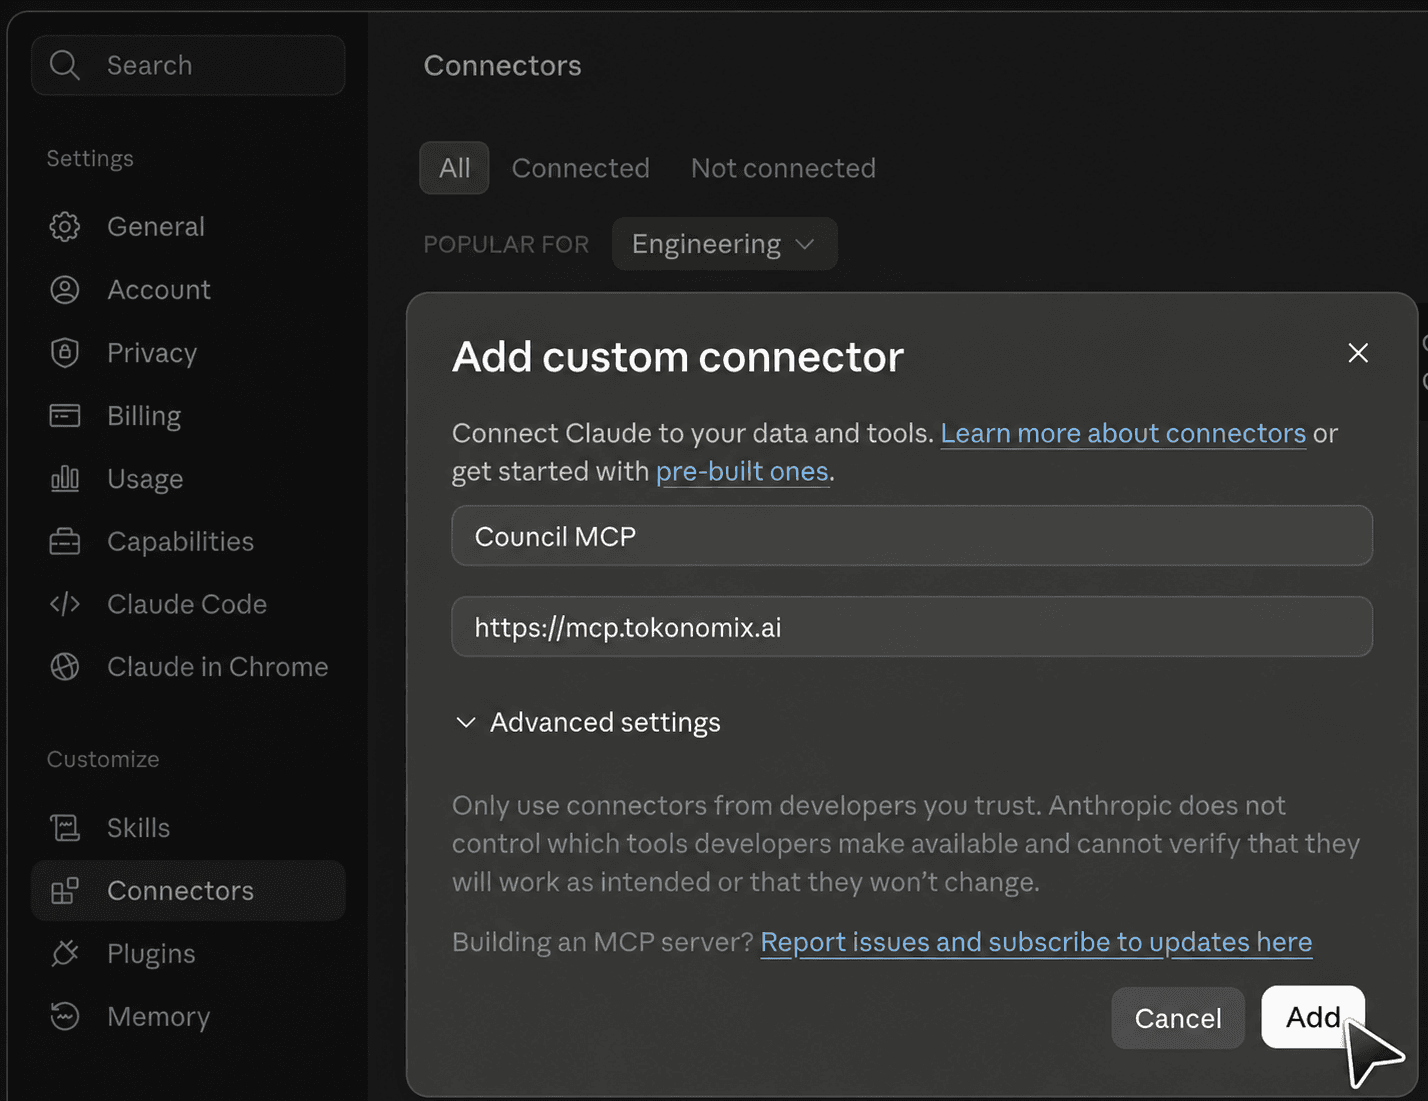
Connectez le MCP
Saisissez un nom, collez https://mcp.tokonomix.ai, cliquez sur Ajouter puis connectez-vous via Tokonomix. Ensuite, Claude accède directement aux outils et aux données de Tokonomix — rien d'autre à configurer.
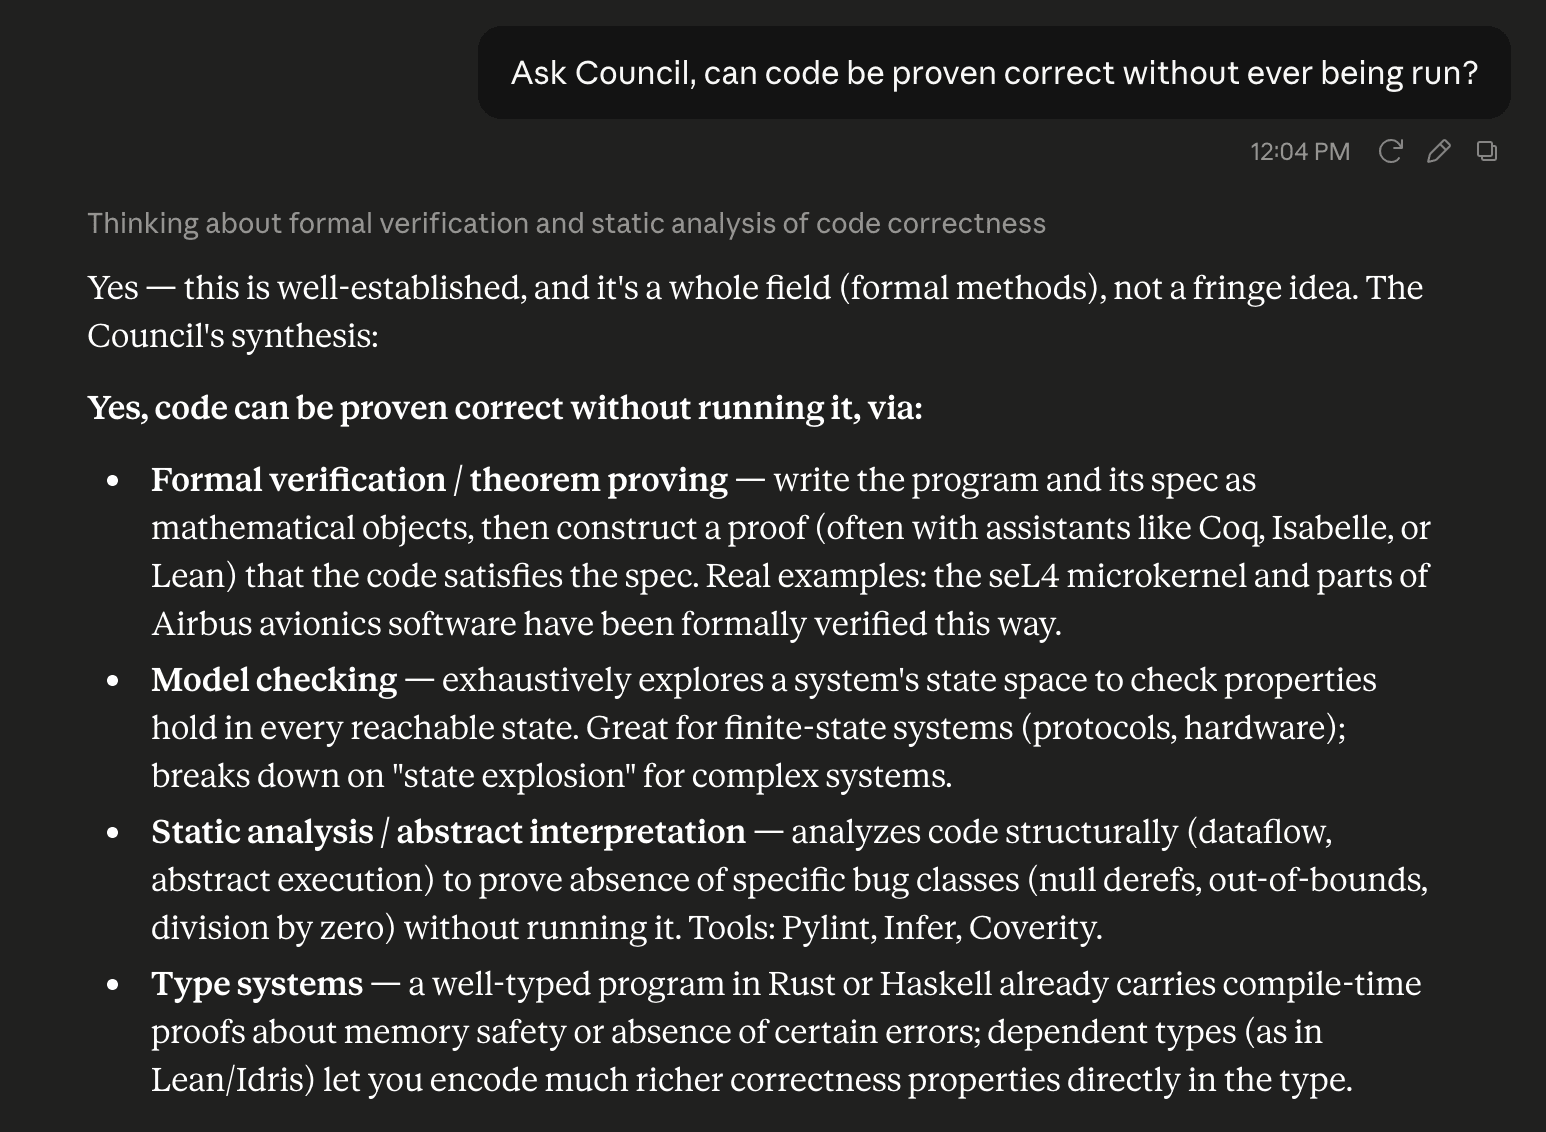
Interrogez le council
Envoyez une requête par le connecteur et Tokonomix la soumet à plusieurs modèles en même temps, aveugles les uns aux autres. Vous recevez un verdict, la réponse de chaque modèle et le coût du tour.
Les meilleurs modèles, par capacité
Mêmes prompts, mêmes conditions, mesurés via notre propre passerelle. Score de qualité, latence et prix de sortie côte à côte — choisissez l’onglet qui correspond à votre usage.
Taux de victoire face à un modèle moyen sur les prompts de cette capacité — 50% est la moyenne. Ce n’est pas un pourcentage de bonnes réponses.
Benchmark en direct
| # | Modèle | Fournisseur | Taux de victoire | Latence | Sortie / 1M |
|---|---|---|---|---|---|
| 01 | gpt-6-luna | OpenAI | 87.4% | 2.85s | $0.9800 |
| 02 | gpt-6-astra | OpenAI | 77.0% | 2.71s | $65.00 |
| 03 | Gemini 3.5 Flash-Lite | Google Gemini | 72.0% | 696ms | $3.74 |
| 04 | gpt-5.2 | OpenAI | 69.5% | 1.82s | $18.20 |
| 05 | gpt-4.1 | OpenAI | 67.1% | 765ms | $11.96 |
| 06 | gpt-5.1 | OpenAI | 65.0% | 2.13s | $13.00 |
moyenne mobile sur 7 jours · dernier test 25 oct.
Verdicts du juge
7 328 évaluations sur 75 modèles — uniquement des décomptes, jamais les prompts des clients.
Juge neutre
Classé sur l'exactitude · minimum 10 exécutions évaluées
| # | Modèle | Verdicts | Exact | Exécutions |
|---|---|---|---|---|
| 01 | Claude Opus 4.6 | 98 % | 160 | |
| 02 | Claude Opus 4.5 | 96 % | 160 | |
| 03 | gpt-4.1-2025-04-14 | 95 % | 175 | |
| 04 | gpt-4.1-mini | 94 % | 177 | |
| 05 | gpt-5.5-2026-04-23 | 94 % | 86 | |
| 06 | Claude Opus 4.7 | 94 % | 161 | |
| 07 | gpt-4.1 | 93 % | 176 | |
| 08 | Claude Sonnet 4.5 | 93 % | 161 |
Livrez des images IA parfaites, à chaque fois.
Cinq modèles d'IA inspectent chaque image à la recherche des défauts que les humains repèrent en premier : doigts en trop, ombres brisées, physique impossible.. etc.
Nouveau · accès anticipé
BETA 2026-07 · LOKI-35 + Vraies Photos de Contrôle · Pas une Garantie Produit.
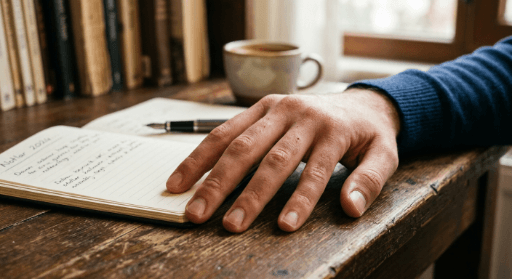
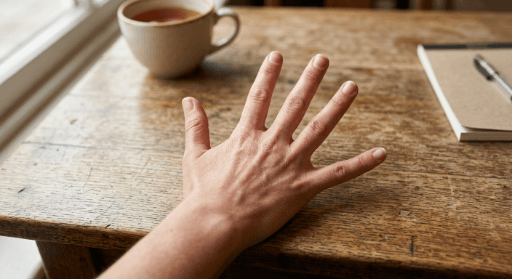
3 sur 5 l'ont détecté. Un seul modèle l'aurait manqué — d'où le conseil.
Tarifs
Ne payez que ce que vous utilisez
Vous rechargez un solde prépayé et chaque appel est payé avec. Sans abonnement, sans minimum, sans frais mensuels.