Top 10 de modelos de IA
| # | Modelo | Tasa de victorias |
|---|---|---|
| 1 | Gemini 3.5 Flash-Lite | 72.1% |
| 2 | gpt-5.6-terra | 72.0% |
| 3 | gpt-5.5-2026-04-23 | 71.8% |
| 4 | gpt-5.1 | 70.5% |
| 5 | gpt-6-astra | 69.8% |
| 6 | gpt-5.2 | 69.0% |
| 7 | gpt-5.2-2025-12-11 | 68.9% |
| 8 | gpt-5.1-2025-11-13 | 68.4% |
| 9 | gpt-5.4-2026-03-05 | 68.4% |
| 10 | gpt-6.1-sol | 67.8% |
Inteligencia paralela, una sola decisión
Cada pregunta se envía a varios modelos de IA a la vez, ciegos entre sí. Sus perspectivas convergen en una única respuesta fiable.
Tokonomix es una pasarela de consenso de IA multimodelo y un benchmark independiente de LLM. Una sola clave API compatible con OpenAI llega a todos los modelos que seguimos; en prompts críticos, varios modelos de frontera responden en paralelo y un juez entre familias los reconcilia en un único veredicto — con la respuesta, los tokens y el coste de cada modelo desglosados. Benchmarks diarios de velocidad y calidad en seis idiomas, publicados abiertamente.
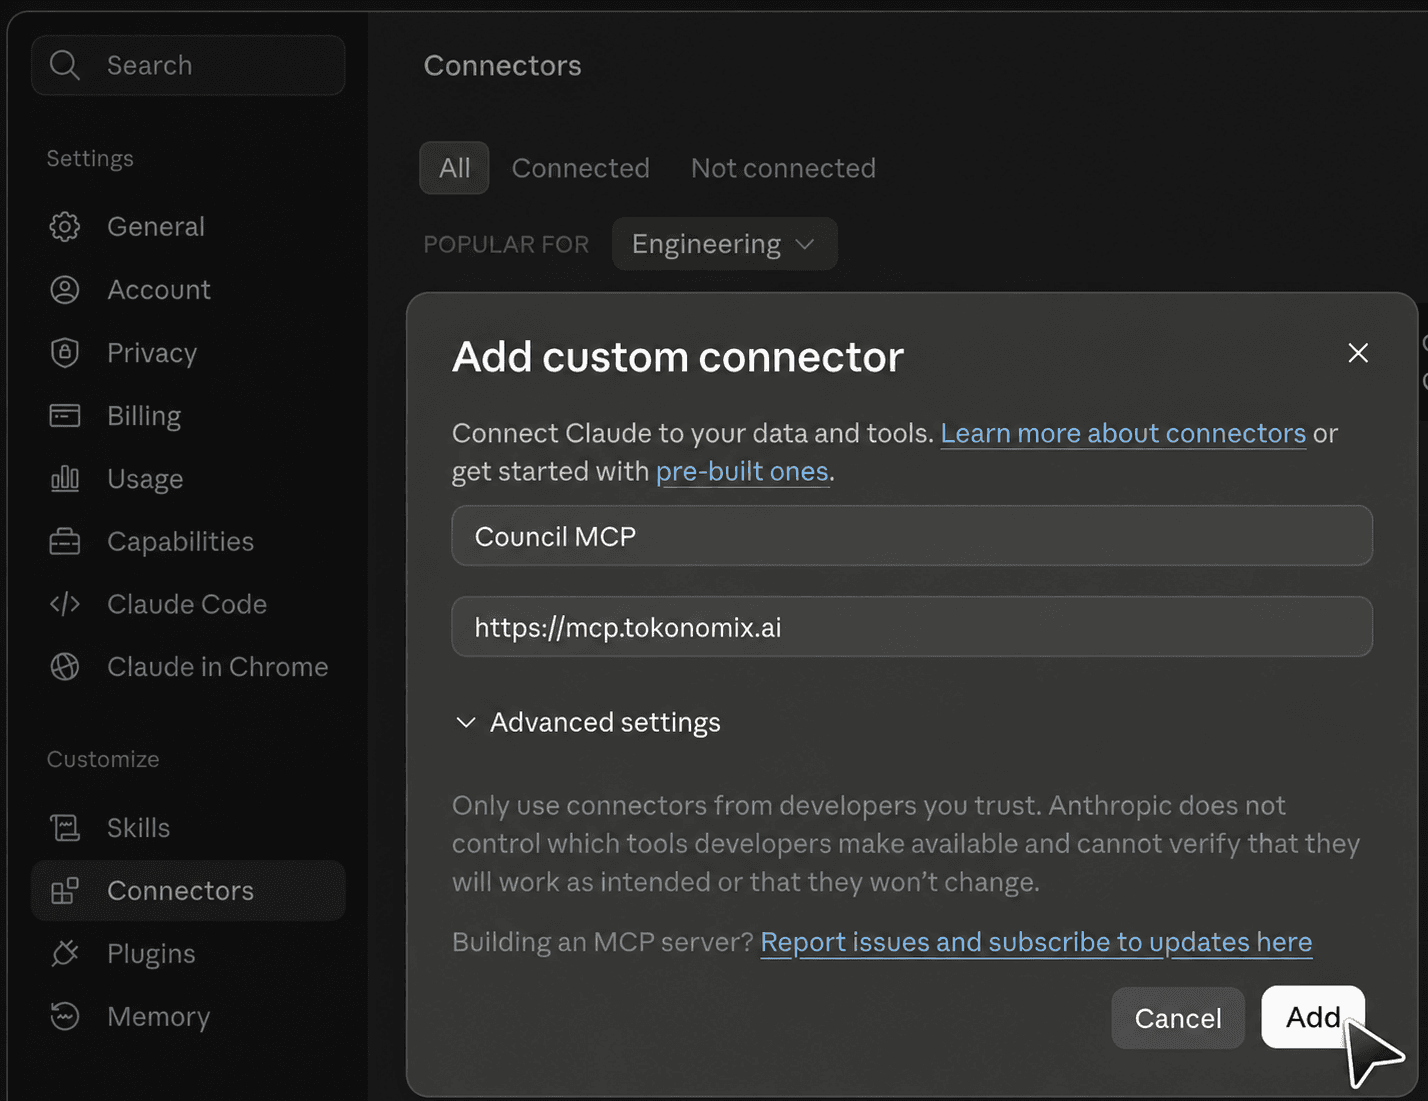
Conecta el MCP
Escribe un nombre, pega https://mcp.tokonomix.ai, pulsa Añadir e inicia sesión a través de Tokonomix. A partir de ahí Claude accede directamente a las herramientas y los datos de Tokonomix — no hay nada más que configurar.
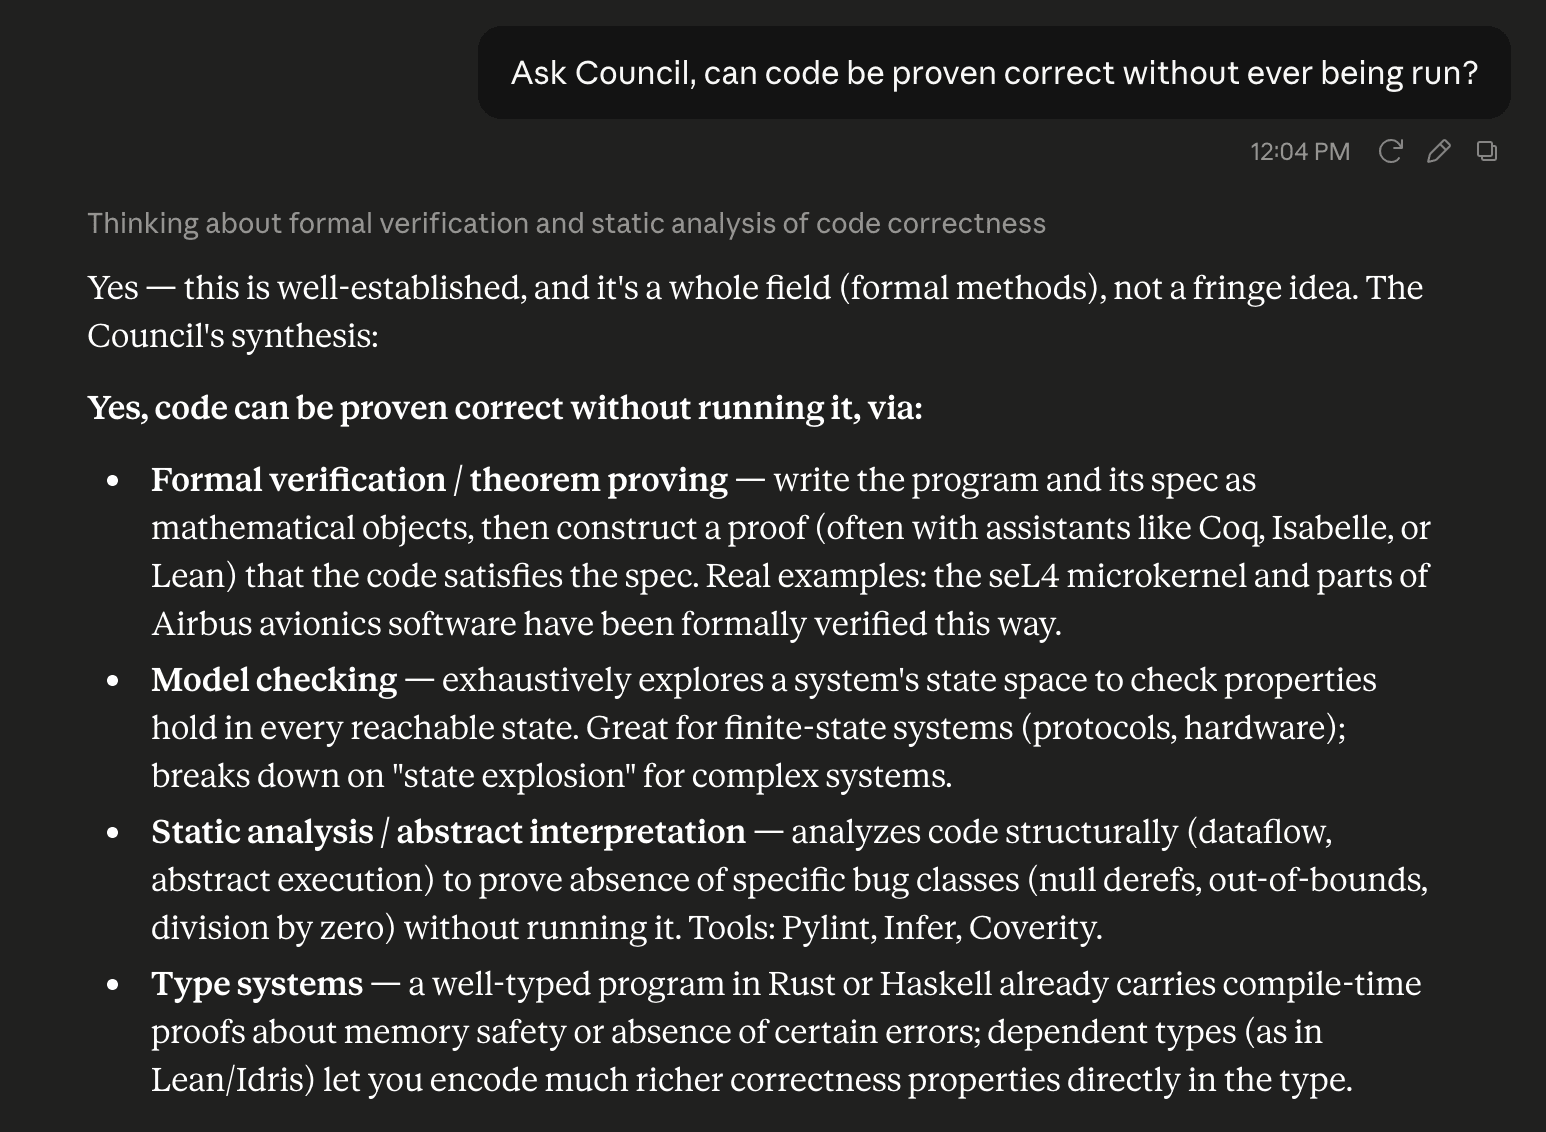
Pregunta al council
Envía una consulta por el conector y Tokonomix la reparte entre varios modelos a la vez, ciegos entre sí. Recibes un veredicto, junto con lo que dijo cada modelo y lo que costó la ronda.
Los mejores modelos, por capacidad
Los mismos prompts, las mismas condiciones, medidos en nuestra propia pasarela. Puntuación de calidad, latencia y precio de salida uno al lado del otro: elige la pestaña que encaje con tu carga de trabajo.
Tasa de victorias frente a un modelo medio en los prompts de esta capacidad — 50% es la media. No es un porcentaje de aciertos.
Benchmark en vivo
| # | Modelo | Proveedor | Tasa de victorias | Latencia | Salida / 1M |
|---|---|---|---|---|---|
| 01 | gpt-6-luna | OpenAI | 87.4% | 2.85s | $0.9800 |
| 02 | gpt-6-astra | OpenAI | 77.0% | 2.71s | $65.00 |
| 03 | Gemini 3.5 Flash-Lite | Google Gemini | 72.0% | 696ms | $3.74 |
| 04 | gpt-5.2 | OpenAI | 69.5% | 1.82s | $18.20 |
| 05 | gpt-4.1 | OpenAI | 67.1% | 765ms | $11.96 |
| 06 | gpt-5.1 | OpenAI | 65.0% | 2.13s | $13.00 |
media móvil de 7 días · última prueba 25 oct
Veredictos del juez
7328 evaluaciones en 75 modelos — solo recuentos, nunca prompts de clientes.
Juez neutral
Ordenado por acierto · mínimo 10 ejecuciones evaluadas
| # | Modelo | Veredictos | Correcto | Ejecuciones |
|---|---|---|---|---|
| 01 | Claude Opus 4.6 | 98 % | 160 | |
| 02 | Claude Opus 4.5 | 96 % | 160 | |
| 03 | gpt-4.1-2025-04-14 | 95 % | 175 | |
| 04 | gpt-4.1-mini | 94 % | 177 | |
| 05 | gpt-5.5-2026-04-23 | 94 % | 86 | |
| 06 | Claude Opus 4.7 | 94 % | 161 | |
| 07 | gpt-4.1 | 93 % | 176 | |
| 08 | Claude Sonnet 4.5 | 93 % | 161 |
Entrega imágenes de IA perfectas, cada vez.
5 modelos de IA inspeccionan cada imagen en busca de los defectos que los humanos detectan primero: dedos de más, sombras rotas, física imposible.. etc.
Nuevo · acceso anticipado
BETA 2026-07 · LOKI-35 + Fotos de Control Reales · No es una Garantía de Producto.
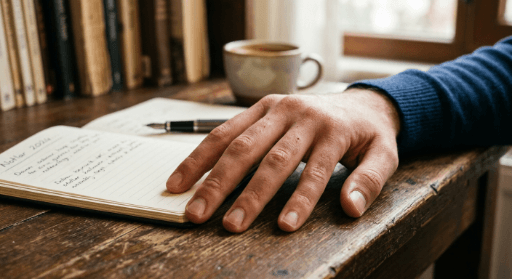
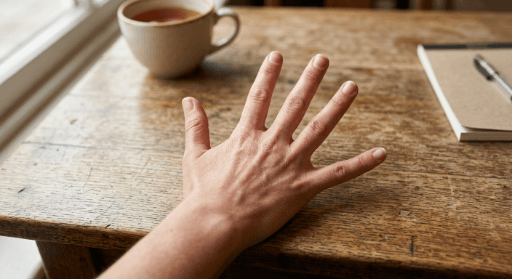
3 de 5 lo detectaron. Un solo modelo lo habría pasado por alto — de ahí el consejo.
Precios
Paga solo lo que usas
Recargas un saldo prepago y cada llamada se paga con él. Sin suscripción, sin mínimo, sin cuota mensual.